本文是对以下论文的阅读梳理与结构化解说;细节以原论文为准,此处不逐段复述证明,仅整理主线逻辑便于对照阅读。
内容总结:代币空投中的博弈
这篇文章的核心逻辑可以概括为以下三点:
- 空投的本质与目的:空投是 DApp 初创企业向早期支持者免费发放代币的行为。其目的是为了市场推广(吸引关注并脱颖而出)以及规避监管(绕过日益严格的 ICO 公开销售限制)。
- 空投的门槛:为了确保代币发给“真实”用户,项目方通常会设置资格要求,最常见的是要求用户与 DApp 产生实际的交互(如转账或调用智能合约)。
- 识别女巫(Sybil):由于空投具有经济价值,大量攻击者会通过自动化脚本创建多个账户进行伪装。文章提出通过图论建模(将账户视为顶点,交易视为边)来分析转账模式和交互规律,从而识别并剔除这些由同一实体控制的可疑账户。
为什么叫“空投”?与《绝地求生》的关系
1. 词源与本意
“空投”(Airdrop)一词最早源于军事或人道主义援助,指利用飞行器将物资从空中直接投放到特定区域。在加密货币语境下,它是一个形象的比喻:代币就像是从天而降的“免费物资”,直接落入用户的数字钱包里,而不需要用户付出金钱购买。
2. 与《绝地求生》(PUBG)的关系
它们在语意逻辑上是高度一致的,虽然所属领域不同,但核心特征相同:
- 稀缺性与奖励:在 PUBG 中,空投箱里装的是高级物资(如 AWM、吉利服);在币圈,空投里是具有潜在价值的代币。
- 规则触发:PUBG 的空投随机掉落或由信号枪召唤;币圈空投则是由满足特定规则(如早期使用过某产品)的用户“召唤”。
- 竞争性:PUBG 里的空投会引来大量玩家争夺,甚至爆发战斗;币圈空投同样引来无数“猎人”通过技术手段(即下文提到的 Sybil)去争抢份额。
什么是 Sybil(女巫)?
在本文语境中,**Sybil(女巫)**指为获取多份空投收益,利用自动化工具创建并控制大量虚假账户的一类行为;从事该行为的实体常被统称为“女巫集群”或“刷子/羊毛党”,与网络安全中的 Sybil 攻击(单实体伪装多身份)同一套概念。
- 概念来源:名称取自 1973 年探讨多重人格障碍的小说《Sybil》,在分布式系统与安全文献里用来描述“一控多号”的攻击面。
- 在文中的具体表现:
- 伪装活跃度:通过 Bot(机器人程序)操作多个账号频繁与 DApp 交互,制造“虚假繁荣”的假象。
- 稀释奖励:女巫行为会瓜分原本属于真实用户的奖励。
- 关联性特点:尽管女巫账户众多,但它们往往在资金来源、操作时间、交互路径上呈现出高度的相似性。文中提到的“图建模”正是为了捕捉这种隐藏在海量数据下的关联规律。
DApp 与协议:分层理解
DApp(Decentralized Application,去中心化应用)并不等同于协议,但二者通常成对出现:日常所说的“某个产品”往往是面向用户的应用层,而其链上规则多由**协议(智能合约集合)**承载。
可以用一个通俗的架构来理解:完整产品体验 ≈ 前端界面(UI)+ 协议(后端逻辑/智能合约)。
1. 协议(Protocol):规则的底层
协议是“法律”和“逻辑”。
在区块链世界,协议通常指代一套智能合约(Smart Contracts)。它定义了资金如何流动、利息如何计算、资产如何抵押等硬性规则。
- 特点:它是代码化的、部署在链上的、不可篡改的。
- 类比:就像 HTTP 协议定义了互联网通信规则,或者银行内部的账务处理系统。你直接看协议,往往是一堆晦涩的代码。
2. DApp:完整的用户产品
DApp 是“包装”后的应用。
用户平时通过网页或 App 使用的界面,常与某一协议绑定;例如大家口语里会说“用 Uniswap、Aave”,严格拆开时:链上那一套规则才是协议,而官网或第三方站点是与之交互的 DApp 前端。
- 前端(Frontend):你看到的网页或 App 界面,方便你点击“兑换”或“存款”。
- 后端(The Protocol):即上述的协议。当你点击按钮时,前端会调用钱包(如 MetaMask)去触发底层协议里的智能合约。
- 存储与通信:通常使用 IPFS 或区块链节点来保证去中心化。
3. 两者的关键区别
| 维度 | 协议 (Protocol) | DApp (Application) |
|---|---|---|
| 表现形式 | 链上的智能合约代码 | 网页、手机 App 或小程序 |
| 受众 | 开发者或机器人(通过 API/合约调用) | 普通用户(通过图形界面) |
| 关系 | 是 DApp 的核心逻辑引擎 | 是协议的交互入口 |
| 可替换性 | 极难更换(逻辑写死在链上) | 可以有多个(不同的 DApp 可以调用同一个协议) |
举个例子:
以 Uniswap 为例:链上的 AMM 合约与规则构成协议;市面上许多不同的网站或聚合器只是不同的前端入口(DApp),底层仍可能调用同一套或分叉后的合约。即使某一官方前端暂时不可用,只要协议合约仍在链上,你仍可通过其他前端或直接调用合约完成交互。
总结
你看到的各种“协议”往往是链上产品的灵魂,而 DApp 是这些规则面向用户的入口与界面。在对话语境下,人们经常混用“产品名”与“协议”,但在技术层面,协议更偏向底层的数学和逻辑规则,而 DApp 则是为了让这些规则变得“好用”而存在的完整程序。
识别 Sybil:案例、行为与资金图
这部分内容深入探讨了识别 Sybil(女巫)攻击的具体模型与技术实现,通过分析链上交互行为的“指纹”来揪出幕后的机器人。
1. 核心研究对象:Hop Protocol
文中选取了 Hop Protocol 作为主要分析案例。这是一个跨链桥协议,用户可以通过它在不同的 Layer 2 网络或以太坊主网之间转移资产。由于这类协议功能丰富(发送、添加流动性、转换、质押),它产生的链上日志非常详尽,为识别 Sybil 行为提供了大量样本。
2. 识别 Sybil 的两个核心维度
研究者提出,机器人控制的账户虽然数量庞大,但在行为逻辑和资金来源上往往会留下难以掩盖的模式:
DApp 活动(行为指纹)
机器人通常执行高度标准化的操作,例如:在一个账户上完成“存入 → 转换 → 质押”这一系列动作后,立即在下一个账户重复完全相同的序列。
相似序列定义:文中给出了数学定义 $Definition 1$,即如果两个账户的操作类型($a$)相同且参数($p$,如转账金额等)相似,则判定其活动序列相似。Token 转账(资金链条)
由于每个虚假账户都需要原生代币(如 ETH)作为 Gas 费用才能与 DApp 交互,机器人控制者必须为这些账户分发资金。
这些资金的流转路径(从母钱包到子钱包)通常呈现出明显的几何特征。
3. 四种典型的转账模式(图示解析)
文中通过图 4 至图 7 展示了 Sybil 资金流转的常见视觉模式:
- 顺序模式(Sequential Pattern):资金像接力棒一样,从账户 A 传给 B,B 再传给 C。这种模式为了省事,但在链上极易被追踪。
- 放射模式(Radiating Pattern):一个中央“母钱包”像章鱼爪一样,同时给几十个子钱包分发小额 Gas 费。
- 先径向、后顺序模式(Complex: Radiating then Sequential):混合型。母钱包先分发给几个中转钱包,中转钱包再进行顺序转账。
- 先顺序、后放射模式(Complex: Sequential then Radiating):另一种混合型,增加了一层层级的隐藏,试图规避简单的图分析。
下方两幅图对应论文 图 4–5 与 图 6–7(左栏:资金在地址间的传递拓扑;右栏:各地址上高度同构的 DApp 行为序列示意)。
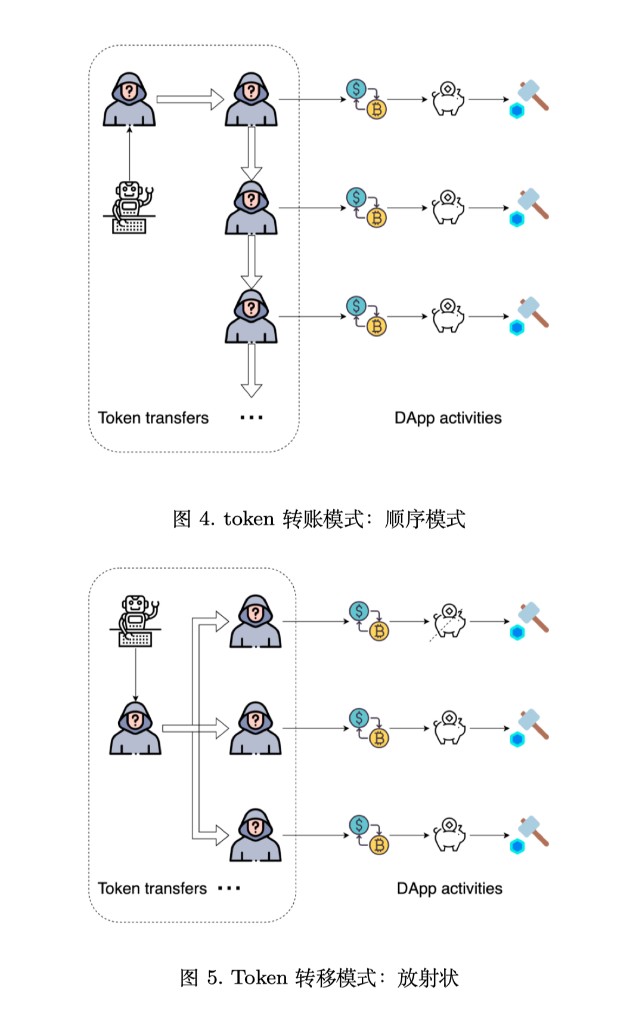
图 4:顺序传递;图 5:自中心母钱包向多子地址放射式分发。
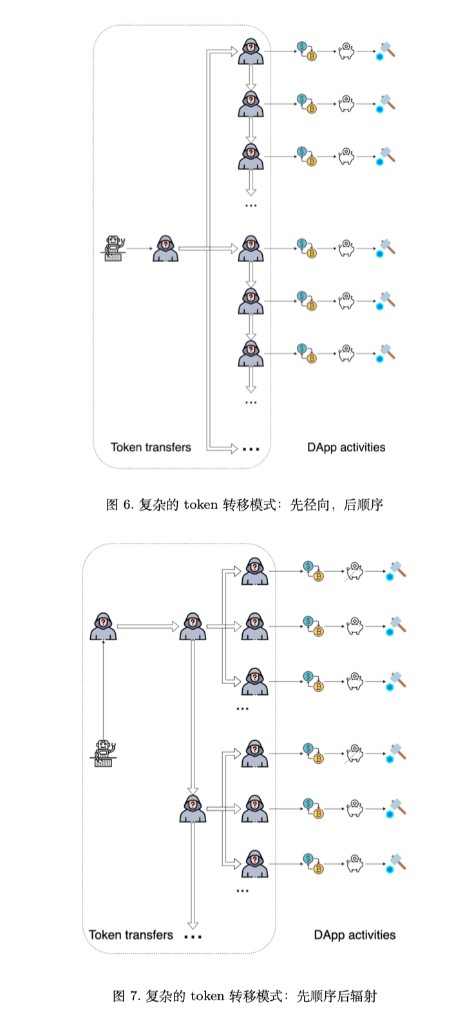
图 6:先放射、再在子链上顺序传递;图 7:沿主干顺序传递并在各层局部放射至叶地址。
4. 技术实现:交易事件日志(Event Logs)
为了获取上述数据,研究者关注的是交易收据中的事件日志(Transaction Receipt Event Logs):
- Transfer(转账):追踪代币的物理流动。
- Sync(同步):反映流动性储备的更新。
- Swap(兑换):记录用户与协议的具体业务交互。
通过提取这些日志中的三元组 $B = (t, a, p)$(时间、类型、参数),研究者可以将凌乱的链上数据转化为可供对比的行为特征向量。
关键结论
仅仅靠“行为相似”不足以断定是 Sybil(因为普通用户也可能看同样的攻略进行操作),但如果“行为序列高度相似”且“资金来源符合特定的转账图模型”,这两个条件同时成立时,该账户集合被判定为 Sybil 的概率极高。这种方法将原本孤立的账户通过“图论”和“序列对比”联系在了一起,让大规模刷票行为无所遁形。
从视觉模式到图算法:顺序与径向
这部分内容是将上一节中视觉化的“代币转移模式”(顺序模式和径向模式)转化为严格的图论问题,并给出了具体的算法实现框架。核心目的是在海量且存在噪音的链上交易图中,高效地提取出符合 Sybil 资金分发特征的子图。
1. 数据预处理与有向图的构建
在进行图算法搜索前,必须先从区块链快照中构建一个干净的基础图结构。
- 构建有向图 $G$:顶点表示独立的地址(Address),若地址 $u$ 向地址 $v$ 发生了代币转移,则在它们之间建立一条有向边。
- 降噪(剪枝)逻辑:
- 机器人分发初始 Gas 费用的行为通常发生在外部账户(EOA,即普通用户钱包)之间。因此,所有涉及智能合约地址的转账均被剔除。
- 中心化交易所(CEX)的地址和预定义的白名单地址被移除。这类地址往往呈现出巨大的星型网络结构,会严重干扰真实 Sybil 网络的拓扑特征。
2. 搜索顺序模式与 Theorem 1(核心推导)
顺序模式表现为资金在多个账户间呈链状传递。在实际链上环境中,这种链条可能并非完美的单向直线(中间可能夹杂其他无关节点的跳跃)。直接在庞大的图 $G$ 中寻找一条恰好覆盖所有可疑节点的简单路径(Simple Path)不仅计算复杂度极高,而且鲁棒性差。
这里,作者通过引入可达性图(Reachability Graph)的概念,给出了一个非常漂亮的转化,并在 Theorem 1 中进行了证明。
- 直观理解:我们不在乎资金从账户 A 到账户 B 中间经过了几个“跳板”(如 1 跳或 2 跳邻居),我们只关心在有向资金流中,A 是否能“到达”B。
- 严格推导:
- 基于原图 $G$,针对给定的可疑节点簇 $U$ 及其 1 跳、2 跳邻居构建子图。然后,构建对应的可达性无向图 $G’ = (V, E’)$。在 $G’$ 中,只要原图 $G$ 中存在 $u$ 到 $v$ 或 $v$ 到 $u$ 的路径,就连接边 $(u,v)$。
- Theorem 1 证明了等价性:在原图 $G$ 中寻找一条能包含节点集 $V$ 的有向路径,等价于在可达性图 $G’$ 中寻找一个完全子图(Clique,小圈子)。
- 这一转换将原本复杂的“有向图特定节点序列搜索问题”,优雅地降维成了图论中经典的“最大团搜索问题(Maximal Clique Problem)”。
Algorithm 1 即是这一数学直觉的工程落地:通过在可达性图中寻找包含最多 $U$ 中顶点的 Clique,逐步剥离出属于同一个顺序资金链的账户集合。
3. 搜索径向模式(Algorithm 2)
相较于顺序模式,径向模式(即一个母钱包向多个子钱包分发资金)的拓扑结构更简单,呈现出典型的星型网络特征。
- 算法逻辑:针对给定的可疑节点簇 $U$,算法在其 1 跳和 2 跳邻居集 $V_h$ 中遍历,寻找一个“超级节点” $v$。其目标函数是最大化 $v$ 在原图 $G$ 中能够到达的 $U$ 中节点的数量。如果找到的 $v$ 能够覆盖 $U$ 中超过 2 个节点,则将其认定为一个径向结构的中心,并将其覆盖的子集提取出来。
4. 总体框架 (Section 4.3)
此处将前文所述的所有模块进行了串联,形成了一个完整的闭环检测系统:
- 行为聚类:首先利用 DBSCAN(一种基于密度的无监督聚类算法)对账户的 DApp 交互行为序列(如前文定义的特征三元组)进行聚类。这一步筛选出“行为高度同构”的可疑账户群 $U$。
- 资金溯源:将上述聚类得到的账户群 $U$ 输入到构建好的交易图 $G$ 中。
- 模式匹配:分别调用 Algorithm 1 和 Algorithm 2,在 $U$ 及其局部邻居网络中搜索是否存在经典的“顺序资金流”或“径向资金流”。如果存在,则完成了从“行为相似”到“资金同源”的双重交叉验证,最终输出高置信度的 Sybil 账户列表。
【插注】DBSCAN 与上文「行为聚类」
下面是对机器学习与数据挖掘中经典的**基于密度聚类(Density-based Clustering)**及 DBSCAN 的译述,并补上一点数学直觉与图论视角;对应你在论文 Section 4.3 第一步里第一次看到 DBSCAN 的位置。
(一)核心定义与算法流程
传统的基于代表点的聚类(如 K-means、EM)擅长椭球状或凸形簇;遇到非凸形状时容易失效——同一簇内两点沿流形的测地距离,可能反而大于跨簇的欧氏距离。DBSCAN 用局部密度来刻画簇的“实体”,从而绕开全局凸包假设。
- $\epsilon$-邻域($\epsilon$-neighborhood):点 $\mathbf{x}$ 的 $\epsilon$-邻域定义为半径 $\epsilon$ 的闭球
$$N_\epsilon(\mathbf{x}) = B_d(\mathbf{x}, \epsilon) = \{\mathbf{y} \mid \delta(\mathbf{x}, \mathbf{y}) \le \epsilon\}$$
其中 $\delta(\mathbf{x}, \mathbf{y})$ 常为欧氏距离(在论文的交互特征空间里也可换成别的度量,但 DBSCAN 的经典叙述以欧氏为主)。 - 核心点(Core point):若 $|N_\epsilon(\mathbf{x})| \ge \texttt{minpts}$,则 $\mathbf{x}$ 为核心点;$\texttt{minpts}$ 是用户给定的局部密度阈值。
- 边界点(Border point):自身不满足 $|N_\epsilon(\mathbf{x})| \ge \texttt{minpts}$,但落在某个核心点 $\mathbf{z}$ 的 $\epsilon$-邻域内。
- 噪声点(Noise / Outlier):既非核心点也非边界点。
连通性(教材里常见的三条关系)
- 直接密度可达(Directly density-reachable):若 $\mathbf{x}$ 为核心点且 $\mathbf{y} \in N_\epsilon(\mathbf{x})$,则称 $\mathbf{y}$ 由 $\mathbf{x}$ 直接密度可达(一般非对称)。
- 密度可达(Density-reachable):若存在点列 $\mathbf{x}_0,\ldots,\mathbf{x}_l$,其中 $\mathbf{x}_0=\mathbf{x}$,$\mathbf{x}_l=\mathbf{y}$,且对每一步 $\mathbf{x}i$ 都由 $\mathbf{x}{i-1}$ 直接密度可达,则称 $\mathbf{y}$ 由 $\mathbf{x}$ 密度可达(仍可能非对称,取决于链上谁是核心点)。
- 密度相连(Density-connected):若存在核心点 $\mathbf{z}$,使 $\mathbf{x}$ 与 $\mathbf{y}$ 都由 $\mathbf{z}$ 密度可达,则称二者密度相连(对称)。基于密度的聚类可严格取为极大密度相连点集。
算法流程与代价
- 许多教材把 DBSCAN 写成类似「Algorithm 15.1」形式的伪代码:先扫一遍数据找核心点,再对每个未归类核心点做递归/队列式扩张,把密度可达点并入同一簇。
- 局限:单一的全局 $\epsilon$ 对多密度数据集很敏感——$\epsilon$ 过小会把稀疏簇当噪声;过大又会把本应分开的稠密簇糊在一起。
- 复杂度:瓶颈在邻域查询;低维可用 kd-tree 等结构做到约 $O(n\log n)$,高维最坏常退化为 $O(n^2)$。
(二)数学直觉:密度水平集与图上的连通分量
不必借助“传染病”一类比喻,也可以在密度估计与离散图之间建立对应。
第一层:把 $(\epsilon,\texttt{minpts})$ 看成离散化的密度阈值
设想样本来自未知密度 $f(\mathbf{x})$。取 $\lambda \approx \texttt{minpts}/\mathrm{Vol}(B_\epsilon)$,则核心点大致落在 ${\mathbf{x}\mid f(\mathbf{x})\gtrsim\lambda}$ 的上水平集离散近似里;边界点靠近该水平集的拓扑边界;噪声点落在低密度尾部。
第二层:核心点诱导的 $\epsilon$-图与连通分支
一种等价整理方式是:
- 以全体核心点为顶点构造图 $G_\epsilon$;
- 若两核心点 $\mathbf{u},\mathbf{v}$ 满足 $|\mathbf{u}-\mathbf{v}|_2 \le \epsilon$,则连边;
- $G_\epsilon$ 的每个极大连通分支给出簇的骨架;
- 再把边界点吸附到距离 $\le \epsilon$ 的某个骨架上。
这解释了 DBSCAN 为何能沿非凸流形“爬行”:它依赖的是局部 $\epsilon$-邻近图的传播,而不是 K-means 那种用 Voronoi 超平面切分全空间。实现里对 DENSITYCONNECTED 一类子过程,本质上常对应在核心点图上做一次 DFS/BFS。
缩略语 D-B-S-C-A-N
Density-Based Spatial Clustering of Applications with Noise:强调在带噪声的空间数据里,用密度与连通性界定簇,而不是强行给每个点分配类中心。其中 Applications 来自 Ester 等(1996)面向大规模数据库空间挖掘的历史语境。
讨论、相关工作与结论(论文末段)
以下对应论文讨论(局限性与未来工作)、相关工作综述与最终结论,侧重客观交代方法在链上的实际表现与适用边界。(若你手边有 PDF,可对照原文章节编号与图示。)
1. 讨论与局限性(Section 6 & 6.2)
作者坦诚了检测框架在真实链上环境里典型的**误报(False Positive)**压力之一:中心化交易所(CEX)的干扰。
- 误报的逻辑起点:许多真实用户会从币安、OKX 等 CEX 提现以太坊作为 Gas。从链上图谱看,CEX 热钱包向大量用户分发资金,拓扑上会形成非常“干净”的**大规模径向(放射状)**结构。
- 巧合导致的误判:若一批彼此独立、但都从 CEX 提现的真实用户,恰好在相近时间段参与了 Hop Protocol 的空投交互(并呈现出相似的 DApp 活动序列),在现有流程下,他们有可能被系统误判为“同一实体控制的 Sybil 集群”。
- 缓解思路:为压低特征重合带来的误报,作者强调需要引入多源交互数据:真实用户行为通常更分散(除空投外还有 Uniswap、NFT 等);而专职薅羊毛的 Bot 往往与目标 DApp 的交互更单一。交互维度越丰富,误判概率通常越低——这与前文“单靠行为相似不足以定罪”的论述是一致的。
2. 未来工作(Section 6.3)
针对上述局限,文章提出两条可演进方向:
- 无预设条件的检测:当前框架依赖项目方在快照时划定的合格地址池作为输入;未来需要研究如何在缺乏明确准入名单(更接近全网盲搜)的前提下,仍高效刻画底层 token 转移网络。
- 跨 DApp、跨链的数据融合:单就某一 DApp(如 Hop)观测,数据量与行为多样性有限,攻击者可通过拉长时间轴、切换入口来稀释痕迹;更可行的路线是融合主网、各 Layer 2 以及其它 DApp 的外部信息,拼出更立体的账户画像。
3. 相关工作(Section 7)
- 传统 Sybil 文献多集中在 IoT、联邦学习、社交网络(水军、垃圾账号等)。
- 区块链语境里,既有研究更常落在共识层(多节点伪装、分片或算力相关威胁等)。
- 本文自陈的站位:作者认为,本文是首次在学术语境下,把“DApp 空投”这一代币经济场景中的 Sybil 作为系统对象来建模与检测——关注点从“节点是否诚实”转向“应用层激励是否被批量身份稀释”。
4. 结论(Section 8)
全文收束时再次强调方法论上的闭环:仅凭“行为相似度”(同一窗口内做同一套操作)不足以断言 Sybil,因为存在羊群效应、公开教程与同质策略。本文主张的是双重验证:
- 先用 DBSCAN 从海量日志中抽出高度相似的 DApp 交互序列聚类;
- 再用图论模块(Algorithm 1 / 2)检验这些地址的初始 Gas 资金路径是否呈现可解释的顺序或径向几何结构。
在作者采用的判定叙事里:“行为同构”与“资金同源(在抽象图模式意义上)”同时成立时,才适合给出高置信度的 Sybil 判定;这也为工程上设置阈值、引入多源数据留出了接口。