这章确实很重要,而且它是 Agent 面试里非常容易被问到的一章。因为很多公司不只是想听你说“我会 LangGraph / RAG / Tool Calling”,而是想看你是否理解:
Agent 为什么能处理复杂任务? 它如何分解问题、调用工具、反思、纠错、继续搜索、最后生成答案?
第 17 章的主题是 推理技术(Reasoning Techniques)。它讲的不是单纯“模型会回答问题”,而是讲 Agent 如何显式地组织自己的思考过程,并把思考、行动、观察、修正结合起来。这一章覆盖了 CoT、ToT、自我纠错、PAL、RLVR、ReAct、CoD、GoD、MASS、推理扩展定律 等内容。
1. 这一章到底在讲什么?
这一章的核心可以概括成一句话:
推理技术(Reasoning Techniques)让 Agent 不再只是“一次性生成答案”,而是能把复杂问题拆成步骤,逐步思考,必要时调用工具,根据反馈修正,并最终得到更可靠的答案。
普通 LLM 回答问题时,常见模式是:
| |
但 Agent 面对的任务通常更复杂,比如:
写代码并调试; 查资料并综合多个来源; 做数学推导; 做复杂规划; 分析法律、医学、金融问题; 根据搜索结果反复补充信息; 执行工具调用后再决定下一步。
这种任务不能只靠一次生成,所以需要更结构化的推理流程:
| |
所以这章讲的是 Agent 的“脑子”如何工作。
注意,这里的“推理”不是神秘能力,而是一些可以工程化实现的机制:
链式思维(Chain-of-Thought, CoT) 树式思维(Tree-of-Thought, ToT) 自我纠错(Self-Correction) 程序辅助语言模型(Program-Aided Language Models, PAL / PALM) 推理与行动(Reasoning and Acting, ReAct) 辩论链(Chain of Debate, CoD) 辩论图(Graph of Debate, GoD) 多智能体系统搜索(Multi-Agent System Search, MASS) 推理扩展定律(Inference Scaling Laws)
这些东西你面试的时候不一定每个都要讲很深,但 CoT、ReAct、自我纠错、工具调用、推理扩展 基本是高频重点。
2. 为什么这章对 Agent 面试重要?
因为公司面 Agent 相关岗位时,真正关心的是:
你是否知道 Agent 不是简单调用一次大模型; 你是否知道复杂任务需要分解; 你是否知道什么时候该搜索、什么时候该计算、什么时候该反思; 你是否知道怎么让 Agent 可靠一些; 你是否知道 ReAct、CoT、Tool Calling、Reflection 之间的关系; 你是否能设计一个可执行的 Agent workflow。
面试官可能不会直接问“请解释第 17 章”,但他会换一种问法:
“Agent 是怎么规划和推理的?” “ReAct 是什么?” “CoT 和 ReAct 有什么区别?” “怎么让 Agent 处理复杂任务更稳定?” “Deep Research 类 Agent 是怎么做的?” “为什么 Agent 需要 reflection?” “多智能体系统怎么优化?” “推理模型为什么更适合复杂任务?” “给你一个复杂搜索任务,你怎么设计 Agent 流程?”
这些问题背后都对应这一章。
3. CoT:链式思维是什么?
链式思维(Chain-of-Thought, CoT) 是这一章的第一个核心概念。
它的意思是:
让模型不要直接给答案,而是先生成中间推理步骤,再得到最终答案。
第 2 页的图 1 展示了 CoT 的结构:输入问题之后,模型依次经过 A、B、……、Z 多个中间步骤,最后得到答案。也就是从一个直接映射:
| |
变成:
| |
这对于复杂问题很重要。因为很多任务不是一步能解决的,比如数学题、逻辑题、多跳问答、复杂解释。CoT 的作用就是把一个大问题拆成多个小问题。
比如用户问:
经典计算机和量子计算机有什么区别?并举一个量子计算应用。
直接回答也可以,但 CoT 会先拆:
第一步:识别问题要求。 第二步:找关键词。 第三步:列出核心概念,比如比特、量子比特、叠加、纠缠。 第四步:组织答案。 第五步:检查是否覆盖了区别和应用。
这就是第 3 页例子展示的流程。
4. CoT 的本质是什么?
CoT 的本质不是“让模型装作在思考”,而是:
把一个复杂映射拆成多个中间状态,让模型每一步只解决一小部分问题。
比如原来模型要直接学:
| |
CoT 让它变成:
| |
这样做有几个好处。
第一,复杂任务更容易处理。 因为每一步负担更小。
第二,中间过程更容易检查。 如果答案错了,可以看是哪一步出了问题。
第三,更适合 Agent。 因为 Agent 不是只回答,它还要决定下一步做什么。
但这里你要注意一个面试细节:现在很多系统不会把完整 Chain-of-Thought 原样展示给用户,而是展示简洁推理摘要或结果说明。因为内部推理链可能冗长、脆弱,也可能包含不适合直接暴露的信息。
所以你面试时可以说:
CoT 的工程价值在于引导模型进行多步分解和中间状态组织,但在产品中通常不会完整暴露原始推理链,而是输出结构化解释或关键依据。
这句话会比只说“让模型一步步思考”更成熟。
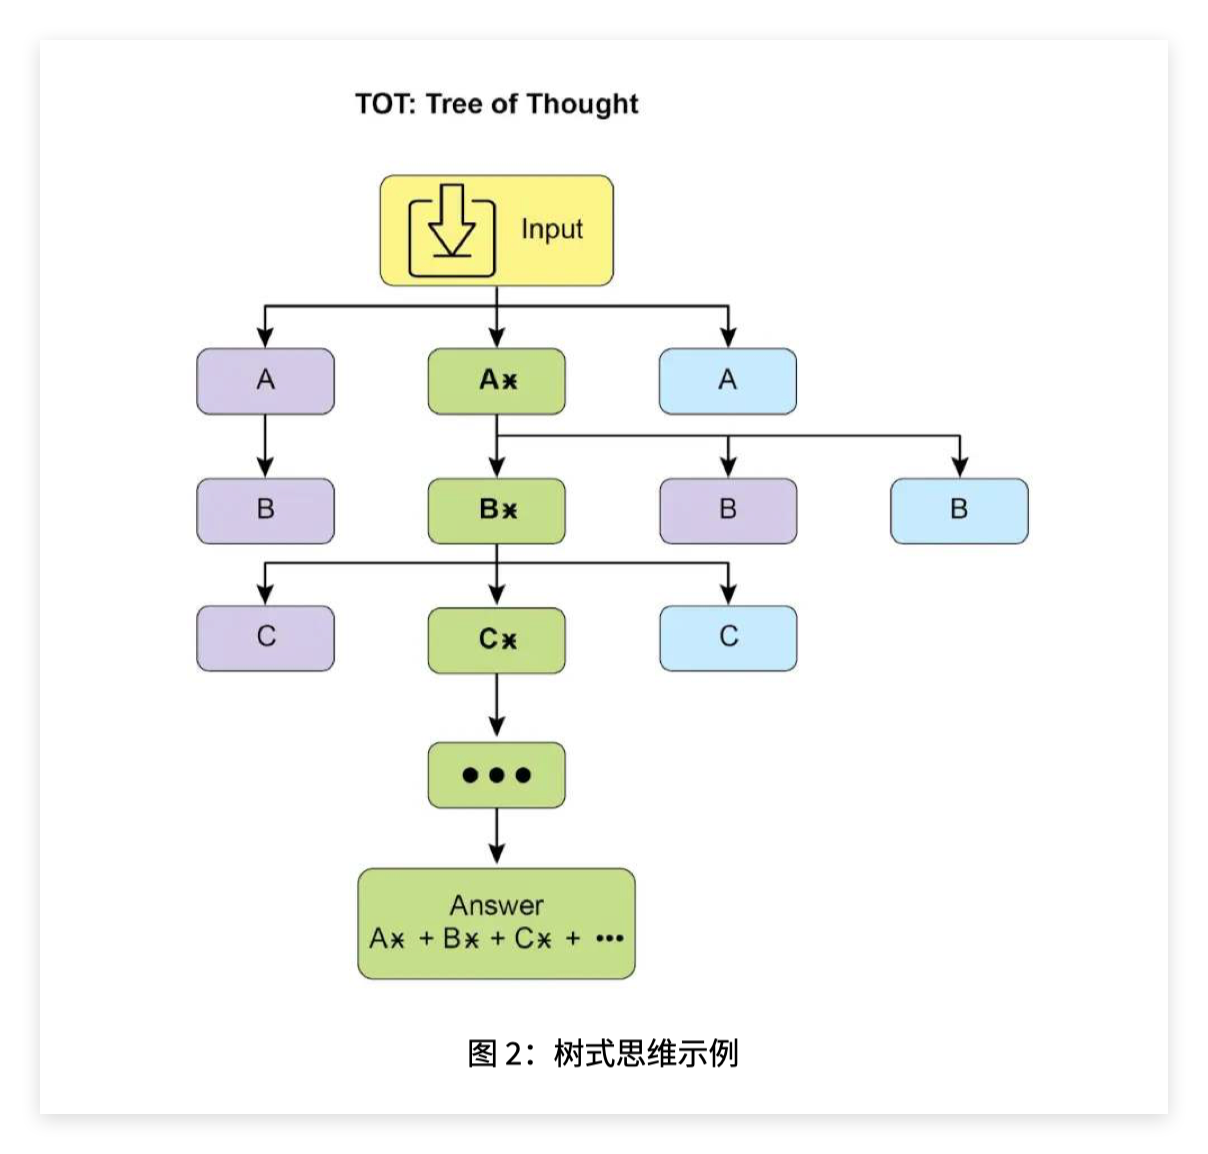
5. ToT:树式思维是什么?
树式思维(Tree-of-Thought, ToT) 是 CoT 的扩展。
CoT 是一条链:
| |
ToT 是一棵树:
| |
第 4 页图 2 展示了 ToT 的结构:输入之后不是只走一条路线,而是同时探索多个分支,最后选择更优路径。
CoT 更像:
我沿着一个思路往下推。
ToT 更像:
我先想几种可能方案,再评估哪条更好。
这在什么场景重要?
策略规划; 复杂决策; 代码调试; 写作方案选择; 游戏推理; 数学证明; 多方案优化。
比如你让 Agent 做一个项目方案,它不应该只生成一个方案,而应该考虑:
方案 A:成本低,但效果一般。 方案 B:效果好,但开发周期长。 方案 C:折中。 然后评估利弊,选择最合适的方案。
这就是 ToT 的思想。
6. CoT 和 ToT 的区别
面试里很可能问这个。
你可以这样回答:
链式思维(Chain-of-Thought, CoT) 是线性推理。模型沿着一条路径逐步分解问题,适合步骤明确的问题,比如数学计算、简单逻辑推理、多步问答。
树式思维(Tree-of-Thought, ToT) 是分支探索。模型同时探索多个候选思路,评估、回溯、选择更优路径,适合开放性、策略性、需要比较多个方案的问题。
简单对比:
| 技术 | 中文名 | 结构 | 适合任务 |
|---|---|---|---|
| Chain-of-Thought, CoT | 链式思维 | 单一路径 | 数学题、多步问答、逻辑题 |
| Tree-of-Thought, ToT | 树式思维 | 多路径搜索 | 规划、决策、复杂问题求解 |
一句话:
CoT 是“沿一条路想清楚”,ToT 是“多想几条路再选择”。
7. 自我纠错是什么?
自我纠错(Self-Correction) 是这一章另一个重要概念。
它的意思是:
Agent 生成初稿后,不立即返回,而是先检查自己的输出,找问题,再修订。
第 4 到第 5 页给了一个社交媒体文案例子。用户要求写一条 150 字符以内的环保产品文案。初稿比较平淡,于是自我纠错智能体检查它的问题:吸引力不足、环保特点不突出、号召性一般、缺乏新品发布感。然后再生成更好的版本。
这个流程可以抽象成:
| |
它在 Agent 系统里非常重要,因为 LLM 第一次输出经常不稳定。
8. 自我纠错和 Critic Agent 有什么关系?
前一章讲过 批判智能体(Critique Agent / Critic Agent)。这里的自我纠错和它关系很近。
有两种实现方式。
第一种是单模型自我纠错:
| |
第二种是多智能体评审:
| |
第二种更像工程化 Agent 系统。
比如:
| |
这就是很多 Deep Research 类系统的基本结构。
但是你要注意:自我纠错不是万能的。模型如果本身不知道正确答案,单纯让它“检查一下”可能只是生成更自信的错误。因此更可靠的自我纠错通常要结合:
工具验证; 代码执行; 搜索结果; 数据库查询; 单元测试; 外部规则; 多模型交叉检查。
这个点很适合面试时讲出来。
9. PAL / PALM:程序辅助语言模型是什么?
这一章提到 程序辅助语言模型(Program-Aided Language Models, PAL / PALM)。
它的核心思想是:
让模型负责理解问题和生成代码,让程序负责精确计算。
LLM 擅长语言理解、任务拆解、生成代码,但它不擅长精确算术、复杂表格计算、大量数据处理。那怎么办?
让模型写 Python,然后执行代码。
流程是:
| |
第 5 到第 6 页的 Google ADK 示例里有两个 Agent:一个 SearchAgent 负责 Google 搜索,一个 CodeAgent 负责代码执行,RootAgent 把这两个工具型 Agent 包起来。
这个在面试里非常重要,因为很多 Agent 项目不是只聊天,而是要真的解决问题。比如:
数据分析 Agent; SQL Agent; 代码生成 Agent; 数学求解 Agent; 报表生成 Agent; 自动调试 Agent。
这些系统都可能用 PAL 思想。
10. 为什么 PAL 很重要?
因为它解决了一个关键问题:
LLM 的自然语言推理不可靠,但代码执行是可验证的。
比如你问:
1234567 × 987654 是多少?
让模型直接算,可能错。
但让模型生成:
| |
再执行,就可靠得多。
再比如数据分析:
用户问:
上个月不同渠道的转化率是多少?
LLM 不应该凭空回答,而应该生成 SQL 或 Python,查询真实数据。
所以 PAL 的本质是:
用 LLM 做语义理解和程序生成,用外部执行环境做确定性计算。
这也是 Agent 和普通 Chatbot 的重要区别。
普通 Chatbot:
| |
Agent:
| |
11. RLVR:可验证奖励强化学习是什么?
这一章提到 可验证奖励强化学习(Reinforcement Learning with Verifiable Rewards, RLVR)。
这个概念比较前沿,也很容易和 reasoning model 关联起来。
它的意思是:
对于有明确标准答案的问题,比如数学题、代码题,可以让模型通过试错学习更好的推理过程。只要最终答案能验证对错,就可以给奖励信号。
传统监督微调需要人工写出标准推理过程。
但 RLVR 不一定需要人工标注完整过程。它只需要知道:
答案对不对; 代码测试过没过; 数学结果是否正确; 任务是否完成。
于是模型可以通过大量尝试,学习怎样生成更有效的长推理链。
这就是现在很多 推理模型(reasoning models) 背后的关键思想之一:它们不是只学会“回答”,而是学会在回答前分配更多 思考时间(thinking time),进行规划、检查、回溯、修正。第 6 页也提到,新型推理模型会在推理前分配可变的思考时间,生成更长、更动态的推理链,支持自我纠错和回溯。
面试里你可以这么说:
RLVR 适合数学、代码、逻辑这类结果可验证的任务。它通过可验证结果作为奖励信号,让模型学会更有效的推理轨迹,而不是只模仿人工写的过程。
12. ReAct:这一章最重要的面试点
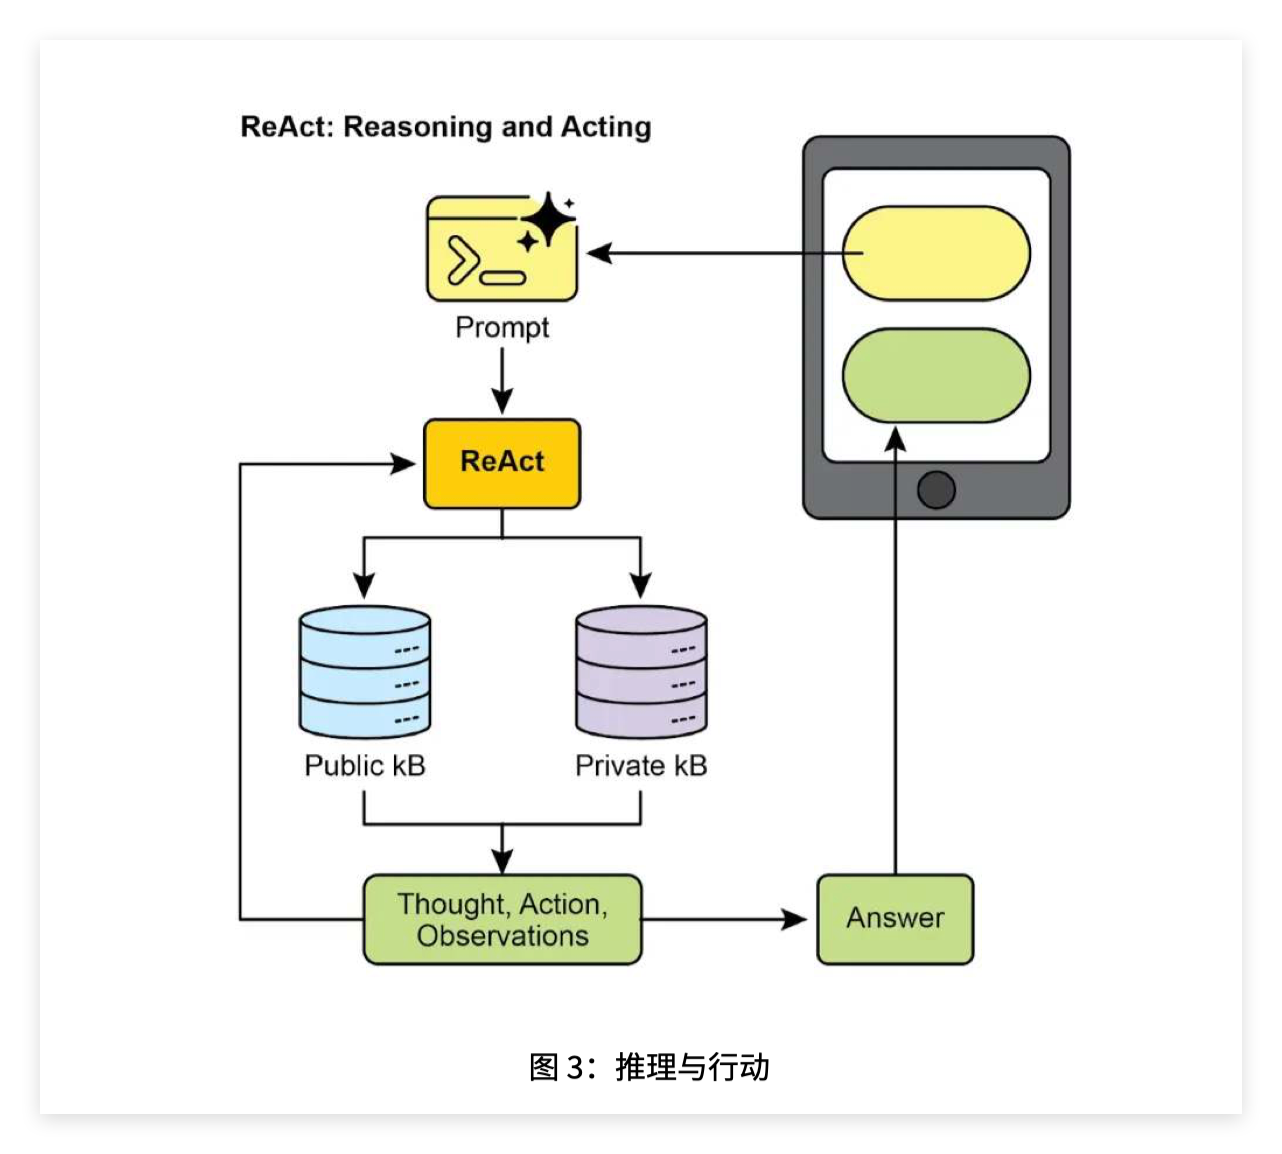
ReAct(Reasoning and Acting,推理与行动) 是这一章最重要的 Agent 技术之一。
它把两件事结合起来:
Reasoning:推理 模型分析当前问题,决定下一步该做什么。
Acting:行动 模型调用工具、搜索、查询数据库、执行代码、访问 API。
ReAct 的核心循环是:
| |
中文可以叫:
| |
第 7 页图 3 展示了 ReAct 的结构:Prompt 进入 ReAct 模块,Agent 可以访问 Public KB 和 Private KB,然后经过 Thought、Action、Observation 的循环,最后生成 Answer。
这就是 Agent 的基本工作模式。
13. ReAct 为什么比 CoT 更像 Agent?
CoT 只有推理,没有真正行动。
| |
ReAct 有推理,也有行动。
| |
举个例子。
用户问:
帮我查一下最近某家公司财报的关键变化,并总结影响。
CoT 只能在模型已有知识里推理,可能过时。
ReAct 会这样做:
| |
所以 ReAct 是从“语言推理”走向“环境交互”的关键。
这也是为什么它是 Agent 面试高频点。
14. CoT 和 ReAct 的区别
这个一定要会。
链式思维(Chain-of-Thought, CoT) 主要解决“怎么想”的问题。 它让模型把复杂问题拆成中间步骤,但不一定调用外部工具。
推理与行动(Reasoning and Acting, ReAct) 解决“边想边做”的问题。 它不仅推理,还会调用工具,并根据工具返回结果继续调整。
对比:
| 技术 | 中文名 | 是否调用工具 | 核心作用 |
|---|---|---|---|
| CoT | 链式思维 | 不一定 | 分解复杂问题 |
| ToT | 树式思维 | 不一定 | 探索多条推理路径 |
| ReAct | 推理与行动 | 是 | 推理、工具调用、观察反馈循环 |
| PAL | 程序辅助语言模型 | 是,代码执行 | 用程序完成精确计算 |
一句话:
CoT 是“想清楚”,ReAct 是“想一步,做一步,看结果,再决定下一步”。
15. DeepSearch / Deep Research 类 Agent 是怎么回事?
这一章后面讲了 Google 开源的 DeepSearch 例子。它基于 Gemini 2.5 和 LangGraph,项目里有 React 前端和 LangGraph 后端,用于高级研究和对话 AI。它的流程包括生成查询、Web 检索、反思、最终答案。
第 9 页图 6 很重要。它展示了 DeepSearch 的多次反思流程:
| |
这就是典型的 Deep Research Agent 模式。
它不是搜一次就回答,而是:
先生成搜索查询; 执行搜索; 检查搜索结果是否足够; 如果不够,继续搜索; 如果足够,再生成最终答案。
这个流程非常适合面试讲项目。
16. DeepSearch 的 LangGraph 代码在做什么?
第 10 页给了一个 LangGraph 示例。它定义了四个节点:
| |
然后设置边:
| |
也就是:
| |
这段代码最关键的是:
| |
它表示 条件边(conditional edges)。
也就是说,Agent 不是固定线性流程,而是根据 reflection 的判断决定下一步:
如果信息不够,回去继续搜索; 如果信息够了,进入最终回答。
这就是 LangGraph 特别适合 Agent 的原因:它可以把 Agent 的推理流程做成一个有状态的图。
17. “智能体如何思考”这一节在讲什么?
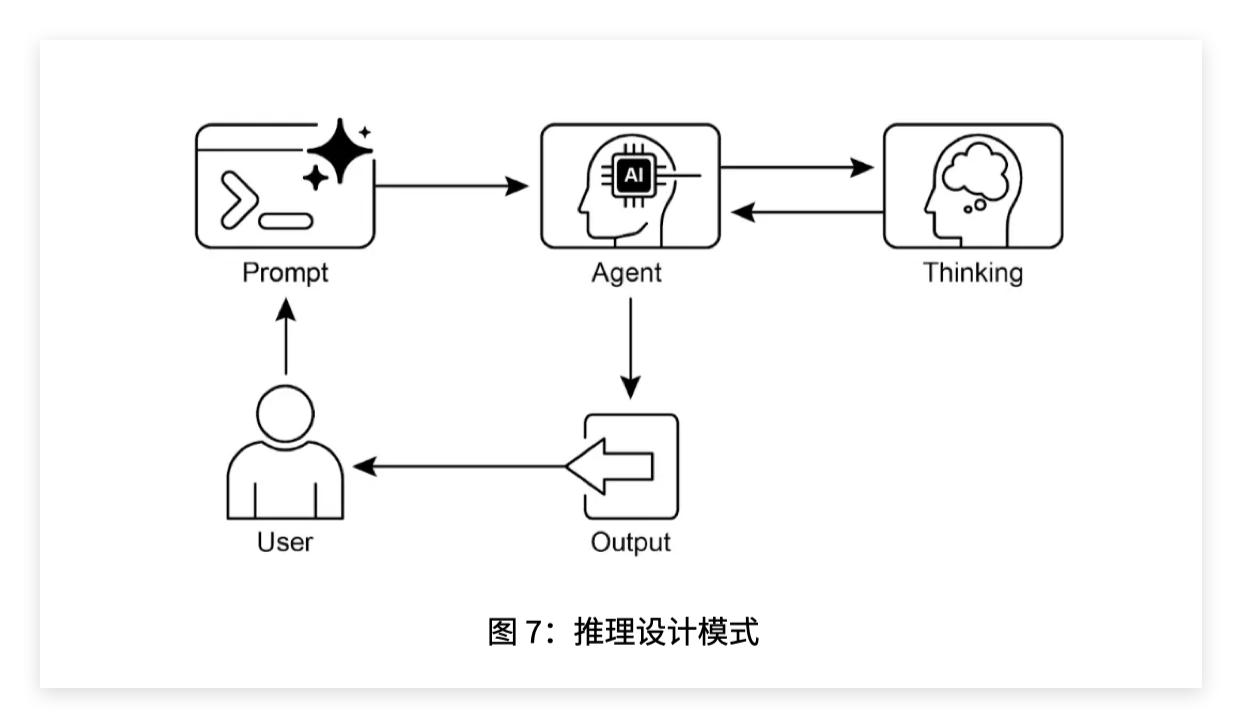
第 10 到第 11 页总结了 Agent 的思考流程:
- 思考(Thought):分析问题、制定计划、分解任务。
- 行动(Action):选择工具,比如搜索、数据库查询、代码执行。
- 观察(Observation):读取工具返回结果。
- 重复循环,直到可以给出最终答案。
这其实就是 ReAct 的通用形式。
你可以把 Agent 的“思考”理解成:
LLM 负责生成下一步决策,工具负责改变外部状态或获取信息,观察结果再反馈给 LLM,形成闭环。
也就是:
| |
这是 Agent 和普通 LLM 应用的根本区别之一。
18. 推理扩展定律是什么?
推理扩展定律(Inference Scaling Laws) 是这一章另一个很重要但容易被忽视的点。
它的核心观点是:
模型效果不只取决于模型大小,也取决于推理阶段分配了多少计算资源。
以前很多人默认:
| |
但推理扩展定律强调:
| |
第 8 页说,小模型如果有足够的“思考预算”,比如生成多个候选答案、做自洽筛选、多路径搜索,也可能超过一个只做简单推理的大模型。
这对 Agent 很关键。
因为 Agent 系统可以选择:
调用一次大模型; 调用多次小模型; 让模型多生成几个候选; 用 Critic 筛选; 用工具验证; 让系统多轮搜索; 通过 LangGraph 多次反思。
这些都是 推理阶段增加计算资源(test-time compute / inference-time compute) 的方式。
19. 推理扩展和第 16 章资源感知优化有什么关系?
第 16 章讲 资源感知优化(Resource-Aware Optimization)。 第 17 章讲 推理技术(Reasoning Techniques)。
它们其实是连在一起的。
第 16 章问:
资源怎么分配最合理?
第 17 章回答:
资源可以分配到更长推理、多路径探索、工具调用、反思、搜索、代码执行上,从而提升答案质量。
比如你有 10 秒预算,可以设计:
| |
如果你有 60 秒预算,可以设计:
| |
所以 Agent 的强弱不只是看模型,而是看你如何分配推理预算。
这就是面试里很容易拉开差距的地方。
20. CoD:辩论链是什么?
辩论链(Chain of Debate, CoD) 是一种多智能体协作推理方式。
它不是让一个模型单独思考,而是让多个模型或多个 Agent 互相提出观点、批评、反驳,最后形成更可靠的结论。
你可以理解成:
| |
它的目标是:
减少单一模型偏见; 发现推理漏洞; 提高答案质量; 形成更透明的推理记录。
这在复杂分析类任务中有用,比如:
法律分析; 医学诊断辅助; 战略决策; 投资研究; 舆情分析; 复杂代码架构评审。
但它的缺点也明显:成本更高、延迟更大、系统更复杂。
所以面试时可以说:
CoD 适合高价值、高风险、需要多角度论证的任务,但不适合简单问答,因为多智能体辩论会显著增加成本和延迟。
21. GoD:辩论图是什么?
辩论图(Graph of Debate, GoD) 比 CoD 更复杂。
CoD 还是比较线性的:
| |
GoD 是图结构:
| |
它把讨论建模为一个动态网络。每个观点是节点,支持或反驳关系是边。
这适合非常复杂的问题,因为真实讨论往往不是一条线,而是多个论点同时发展、交叉、合并。
比如分析一个商业决策:
市场因素; 技术因素; 合规因素; 成本因素; 竞争因素; 用户增长因素。
这些因素之间不是线性关系,而是互相支持或冲突。GoD 的思想就是把这种复杂结构显式表示出来。
这个在一般面试里不会是重点,但如果你讲多智能体系统,它可以作为加分项。
22. MASS:多智能体系统搜索是什么?
多智能体系统搜索(Multi-Agent System Search, MASS) 是更进阶的内容。
它要解决的问题是:
多智能体系统到底应该怎么设计?几个 Agent?每个 Agent 的提示词怎么写?Agent 之间怎么连接?谁先说?谁后说?谁评估谁?
MASS 的思想是自动优化多智能体系统设计。
第 7 到第 8 页说它包含三步:
第一步:块级提示优化(Block-Level Prompt Optimization) 先优化每个单体 Agent 的提示词。
第二步:工作流拓扑优化(Workflow Topology Optimization) 再优化 Agent 之间的连接结构,也就是谁和谁交互。
第三步:工作流级提示优化(Workflow-Level Prompt Optimization) 最后从整体系统角度优化全局提示词和协作关系。
简单说:
| |
这对大型 Agent 系统很重要。
比如一个复杂研究系统可能有:
Planner Agent; Search Agent; Reader Agent; Verifier Agent; Writer Agent; Critic Agent。
这些 Agent 怎么组织,效果差别很大。MASS 就是在研究如何自动找到更好的组织方式。
23. 这一章的完整技术关系图
你可以这样理解它们之间的层级:
| |
如果你面试时间有限,优先讲:
| |
这条线最实用。
24. 一个面试级回答:Agent 是如何处理复杂任务的?
你可以这样回答:
对复杂任务,Agent 通常不会一次性生成答案,而是使用结构化推理流程。首先通过 CoT 或任务规划将问题拆解成子任务;如果任务需要外部信息或精确计算,就采用 ReAct 框架,在 Thought、Action、Observation 循环中调用搜索、数据库、代码执行等工具;每轮观察结果后,Agent 会判断信息是否充分。如果不足,就继续检索或执行工具;如果充分,就进入答案生成。为了提升可靠性,可以加入 Reflection 或 Critic Agent,对中间结果和最终答案进行检查和修正。对于高价值任务,还可以使用 ToT 或多智能体辩论,探索多条候选路径并选择最优方案。
这个回答基本覆盖了这一章的主线。
25. 一个项目级设计:Deep Research Agent 怎么做?
如果面试官问你:
你会怎么设计一个 Deep Research Agent?
你可以说:
| |
对应 LangGraph 节点可以是:
| |
这正好对应第 10 页的 LangGraph 示例。
你还可以补一句:
这个系统的关键不是搜索一次,而是通过 reflection 判断 context 是否 sufficient,从而决定继续搜索还是生成答案。
这句话很有面试价值。
26. 一个代码调试 Agent 怎么设计?
这一章也提到代码调试和生成。你可以设计:
| |
这就是 ReAct + PAL + Self-Correction。
关键是:
模型不是直接说“我觉得这样改”,而是要:
读代码; 生成补丁; 运行测试; 观察报错; 继续修正。
这才是 Agent。
27. 一个 RAG Agent 怎么用这一章的技术?
你之前一直在学 RAG,这里可以连起来。
普通 RAG:
| |
Agentic RAG:
| |
这就是 ReAct + Reflection。
所以这章其实是在告诉你:
RAG 不一定是一次检索。复杂 RAG 可以变成一个会反思、会继续检索、会修正答案的 Agent。
28. 面试常问:为什么需要 Reflection?
你可以这样答:
Reflection 的作用是让 Agent 对当前状态进行评估,判断任务是否完成、信息是否充分、答案是否存在漏洞。如果没有 Reflection,Agent 往往会在搜索一次或生成一次后直接结束,容易遗漏信息或产生幻觉。Reflection 可以把流程从线性 pipeline 变成动态闭环,使 Agent 能根据中间结果决定是否继续搜索、调用工具、修正答案或结束任务。
再补充一句:
Reflection 最好结合外部证据或工具结果,而不是只让模型自我评价,否则可能出现自信但错误的修正。
这就比较成熟。
29. 面试常问:ReAct 的缺点是什么?
不要只会吹 ReAct,也要会讲限制。
ReAct 的缺点包括:
第一,成本更高。 因为可能多次调用模型和工具。
第二,延迟更高。 Thought-Action-Observation 循环越多,响应越慢。
第三,容易工具调用错误。 如果模型选错工具、参数错、搜索查询差,结果会偏。
第四,容易循环。 Agent 可能一直觉得信息不够,反复搜索,需要设置最大步数。
第五,观察结果可能污染推理。 如果搜索结果质量差,Agent 可能被错误信息带偏。
第六,需要状态管理。 多轮工具调用需要保存中间状态,LangGraph 这类框架就是为了解决这个问题。
所以工程上要加:
最大迭代次数; 工具调用预算; 错误处理; 结果验证; 日志追踪; fallback; 人工接管机制。
这会和第 16 章资源感知优化连起来。
30. 面试常问:如何防止 Agent 无限循环?
这是 ReAct 系统里非常实际的问题。
可以从几个方面处理:
设置最大步数,例如最多 5 轮工具调用; 设置最大 token 或最大时间预算; Reflection 节点必须输出明确状态:continue 或 finish; 如果连续两次搜索结果没有新增信息,就强制进入总结; 对工具调用结果做去重; 记录已经尝试过的查询,避免重复搜索; 设置 fallback,比如信息不足时明确说明不足,而不是继续编造。
可以说成:
| |
这个问题很容易体现你有没有工程意识。
31. 面试常问:什么时候用 CoT,什么时候用 ReAct?
你可以这样答:
如果问题主要依赖模型已有知识,并且不需要外部工具,可以用 链式思维(Chain-of-Thought, CoT) 或结构化分解。
如果问题需要外部信息、实时数据、数据库、代码执行、文件读取,就应该用 推理与行动(Reasoning and Acting, ReAct)。
例如:
数学推导:CoT 或 PAL。 实时新闻:ReAct + Search。 数据分析:ReAct + SQL/Python。 代码调试:ReAct + Code Execution + Tests。 战略规划:ToT + Reflection。 复杂研究:ReAct + Reflection + Multi-step Search。
32. 面试常问:推理模型和普通模型有什么区别?
结合这一章可以这样回答:
普通模型更偏向直接生成答案,而推理模型会在生成最终答案前分配更多推理计算,进行问题分解、候选路径探索、自我检查和回溯。它们的效果不只来自模型参数大小,也来自推理阶段的 test-time compute。对于数学、代码、复杂逻辑任务,增加推理时间往往能显著提升准确率。
这里要提到两个关键词:
思考时间(thinking time) 测试时计算(test-time compute / inference-time compute)
再补一句:
但推理模型也会带来更高延迟和成本,所以实际系统中要结合资源感知优化,根据任务复杂度决定是否启用深度推理。
这就把第 16 章和第 17 章打通了。
33. 这一章你真正需要背下来的主线
你不需要死记所有名词。你要记住这条主线:
| |
如果压缩成一句话:
第 17 章讲的是如何把 LLM 从“一次性回答器”变成“能分解、搜索、行动、观察、反思、修正的 Agent”。
34. 这一章最适合写进简历或项目的点
如果你做 Agent 项目,可以写:
基于 LangGraph 构建 ReAct-style Agent workflow,实现“查询生成—工具调用—结果观察—反思判断—迭代检索—最终回答”的闭环流程。
或者:
引入 Reflection 节点判断检索上下文是否充分,不足时自动生成补充查询并继续检索,提高复杂问题回答的完整性。
或者:
结合 Tool Calling 与 Code Execution,使 Agent 能在自然语言推理之外调用外部工具完成搜索、计算和验证,降低幻觉风险。
或者:
设计 Critic Agent 对最终答案进行事实一致性和完整性检查,实现自我纠错。
这些都比“我用了 LangChain 做 RAG”更像 Agent 项目。
35. 最后总结
第 17 章的核心不是某一个技巧,而是一整套 Agent 推理体系。
它从最基础的 链式思维(Chain-of-Thought, CoT) 开始,让模型能分步解决问题;再到 树式思维(Tree-of-Thought, ToT),让模型能探索多条路径;再到 自我纠错(Self-Correction),让模型检查和修正输出;再到 程序辅助语言模型(Program-Aided Language Models, PAL),让模型通过代码执行获得可验证结果;最后到 推理与行动(Reasoning and Acting, ReAct),让 Agent 能在“思考—行动—观察”的循环中调用工具、读取反馈并动态调整计划。
对面试来说,最重要的是理解:
Agent 的能力不是来自一次模型调用,而是来自结构化推理流程、工具调用、状态反馈、反思纠错和推理预算分配。
你重点掌握 CoT、ReAct、Reflection、Tool Use、Inference Scaling,基本就能覆盖大多数 Agent 面试问题。
推荐阅读
上一篇:
下一篇: